
学习笔记:AI 相关概念
索引
一、语言模型
BERT
BERT(Bidirectional Encoder Representations from Transformers)是 Google 在 2018 年提出的语言表征模型,用于让机器理解语言:输入自然语言,输出每个 token 融合了上下文语义的向量。虽然 BERT 如今已不是最先进的通用大模型架构,但它的历史地位很重要:它提出的 MLM(Masked Language Model,掩码语言模型)预训练任务,以及它推广的“在海量无标注文本上预训练 + 在具体任务上微调”范式,都影响深远。
公式表示
假设一句话经过 tokenizer 切分后有 个 token,隐藏维度为 ,则输入为 。经过 层 Transformer Encoder 后,输出 的形状保持不变,其第 行是第 个 token 融合上下文语义后的隐藏向量。
预训练任务:MLM
训练时会随机遮盖序列中的部分 token,例如 The cat is sitting on the [MASK],再让模型预测被遮盖的 token,例如 mat。损失函数为
其中, 是被遮盖的 token 位置集合, 是第 个 token, 是除 之外的上下文, 是参数为 的模型给出的概率分布。由于模型能同时看到被遮盖 token 左右两侧的上下文,因此称为 Bidirectional(双向)。
MoE
MoE(Mixture of Experts,混合专家)把传统 Transformer 中一个大的 FFN(Feed-Forward Network,前馈网络)替换成多个小的 FFN,每个小 FFN 称为一个专家(Expert)。每个 token 只经过其中少数几个专家,从而降低推理时的计算量和耗时。
这种只激活部分参数的模型称为稀疏模型(sparse model);相应地,所有参数都参与计算的传统架构称为稠密模型(dense model)。
公式表示
假设有 个专家 ,每个 ,其中 是 token 的隐藏维度。另有一个 Router,参数为 。对于输入 token ,Router 计算 ,表示该 token 在各个专家上的分数;经过 Softmax 后,选取概率最高的前 个专家激活。最终输出 为
有效性
可以这样理解:MoE 把原本覆盖所有领域的大 FFN 拆分成多个专家,训练中每个专家会自发地专注于特定领域;而在实际场景中,每个 token 只与少数领域相关,在其他领域上的权重很低,所以只激活部分专家就能取得很好的效果。此外,一些模型(例如 DeepSeek-V3)采用“大量细粒度专家 + 共享专家(shared expert)”的模式:共享专家兜底所有 token 都需要的通用知识,细粒度专家则分工负责各个具体领域。

优势与劣势
由于推理时只激活一小部分专家,MoE 的计算量(FLOPs,floating point operations)更低。在推理代价相同的情况下,MoE 模型的总参数量往往比稠密模型更大,能够学到更丰富的知识、识别更复杂的模式。同时,不同 token 被路由到分管不同领域的专家,也提高了参数的利用率。
但要注意,即使每个 token 只激活一小部分专家,加载模型时仍需载入全部参数,因此需要更大的显存。此外,如果不同专家分布在不同 GPU 上,频繁的跨设备通信也会带来额外的时间开销。
CoT
CoT(Chain of Thought,思维链)由 Google 在 2022 年提出,指让大模型在给出最终答案之前,先把一部分中间结果以 token 的形式写出来,再基于这些 token 完成后续计算,从而在不改变参数规模的情况下,提升模型在数学、常识推理等任务上的表现。
对同一个模型而言,无论问题简单还是复杂,生成每个 token 时都只经过相同层数的 Transformer 来预测下一个 token,无法针对难题“多想一会儿”。人类思考复杂问题时,大脑结构并没有变化,却会在脑海中一步步推演、搜索和试错。思维链正是模仿了这个过程:虽然每个 token 经过的层数相同,但模型可以输出更多 token,通过多次自回归调用来加深思考。因此,思维链并不是把神经网络内部潜在空间中发生的事情打印出来,而是相当于给模型增加了一张外部草稿纸。
公式表示
不使用 CoT 时,模型直接根据问题 预测答案 ,即建模 。思维链则引入中间的推理序列(reasoning sequence),实际建模的是 ,展开为
其中, 表示第 个推理 token(reasoning token)。因此,CoT 在不改变参数的情况下,通过更长的计算序列增加了测试时计算(test-time compute)。
发展历程
在 CoT 正式提出之前,2021 年的论文 Show Your Work: Scratchpads for Intermediate Computation with Language Models 发现,在程序执行、整数运算、多项式运算等任务中,让模型先输出计算过程、变量状态等中间结果,能有效提升表现。这种做法被称为 Scratchpad(草稿纸)。
2022 年,论文 Chain-of-Thought Prompting Elicits Reasoning in Large Language Models 正式提出了思维链的概念:在提示词中加入带有推理过程的示例,模型在回答时就会倾向于模仿这种结构,先输出推理 token,从而有效提升算术、常识推理等任务的表现。这种给出少量示例的方式称为 few-shot。
同年,论文 Large Language Models are Zero-Shot Reasoners 进一步发现,甚至不需要给出示例,只要告诉模型 Let's think step by step,就能引导模型在回答时输出推理 token。这种方式称为 zero-shot。
以上工作只让模型思考一次。2022 年的论文 Self-Consistency Improves Chain of Thought Reasoning in Language Models 则让模型生成多条思维链及对应结果,选择出现次数最多的结果作为最终答案。其原理是:正确的推理可以有很多条路线,但都会汇聚到唯一的正确答案;而错误往往是随机的,会分散到不同的错误答案上。不过,这种方法无法避免系统性偏差导致的相同错误。
另一项重要工作是 OpenAI 在 2021 年发表的 Training Verifiers to Solve Math Word Problems,它训练了一个单独的 Verifier(验证器)模型,为每个候选答案打分。
真正的颠覆性突破是 2022 年提出的 STaR(Self-Taught Reasoner),出自论文 STaR: Bootstrapping Reasoning With Reasoning。其原理是把模型自己生成的、得到正确答案的 CoT 反过来用于训练模型,把成功经验学进模型参数里。这种想法类似 Model as Agent:把优质的 agent 运行轨迹喂给模型,让模型内化 agentic 能力。
但只用自己做对的题训练,STaR 始终在强化已有能力,难以突破能力边界。因此,STaR 引入了 Rationalization 机制:对于模型做错的题,把问题和正确答案一起交给模型,让它反推出通向正确答案的推理路径(这比直接做对题更容易),再用“问题 + 反推的推理路径 + 正确答案”继续训练。不过,这种方式仍然没有解决答案正确但过程错误的问题。
2023 年,OpenAI 在论文 Let’s Verify Step by Step 中带来了 PRM(Process Reward Model,过程奖励模型),它可以为 CoT 的每个中间步骤打分,更精细地评估推理过程,而不仅仅判断最终结果是否正确。但 PRM 的训练成本非常高,需要大量人工检查并标注每一步推理是否正确。
早期的 PRM 可以看作精细到每一步推理的 Verifier,并没有把能力内化到回答问题的主模型参数中。所以下一步是用 RL(Reinforcement Learning,强化学习)微调代替 SFT(Supervised Fine-Tuning,监督微调):让模型根据每条推理过程的得分自行探索,优化参数以提高生成好的推理过程的概率,同时降低生成差的推理过程的概率。
2024 年,DeepSeekMath 提出了 GRPO(Group Relative Policy Optimization,群组相对策略优化),可以看作一种简化改造的 PPO(Proximal Policy Optimization,近端策略优化)。PPO 在训练主模型 Actor 的同时,还需要训练一个规模相当的价值网络 Critic。GRPO 的核心思路是:对于同一个问题,让主模型生成多条回答,由 Verifier 为每条回答打分,但不需要额外的价值网络,只用组内分数的均值和标准差对得分做标准化,区分出好的和差的回答,在训练时增强好的推理过程,抑制差的推理过程。
2025 年,DeepSeek-R1-Zero 发现,即使不经过高质量 CoT 数据的 SFT,直接在基座模型上进行 RL 训练,模型的推理能力也会提升,并自发涌现出自我检查、更换解题思路等行为。
二、多模态
ViT
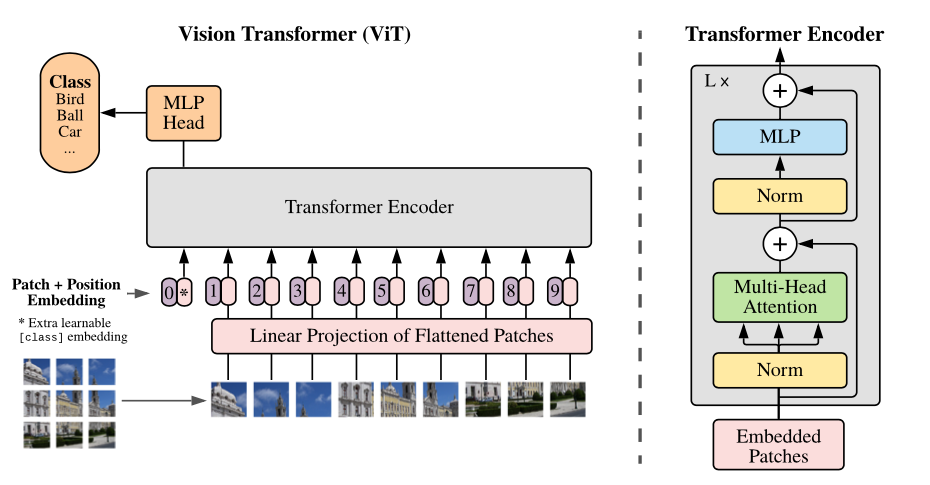
ViT(Vision Transformer)把图片也转化为 token 序列,证明了纯 Transformer 架构无须依赖 CNN,也能直接完成图像识别任务。
公式表示
假设图片 ,其中 、 分别是图片的高度和宽度, 是通道数(例如 RGB 图像 )。若 patch 大小为 ,则图片可以切成 个 patch。每个 patch 的原始尺寸为 ,展平后得到向量 ,再经过线性投影得到 ,其中 , 是 token 的隐藏维度。最后把所有 patch 对应的 token 拼接起来,得到 ,作为 Transformer 的输入。
与 CNN 的对比
CNN(Convolutional Neural Network,卷积神经网络)把卷积核当作小型滤波器,在整张图片上滑动扫描,相当于用同一套标准检测每个局部区域并提取特征;每个卷积核对应一个输出通道,代表一种特征。这种设计借鉴了人类观察物体的方式:先关注局部的颜色、形状、线条等特征,再拼合成完整的物体。ViT 的思路则是把图片切成多个 patch,让模型自己学习 patch 之间的关联。
VLM
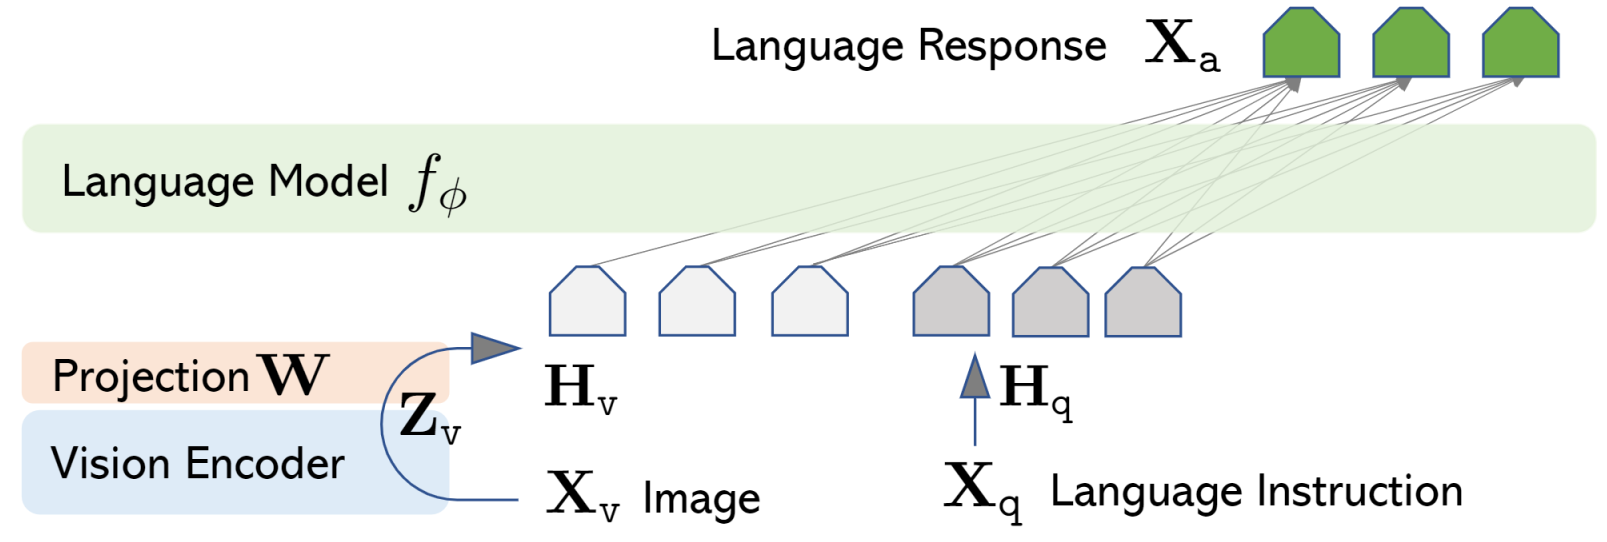
VLM(Vision-Language Model,视觉语言模型)把视觉信息 token 化,与文本一起映射到语言模型能够理解的语义隐藏空间中。
三、生成模型
VAE
VAE(Variational Autoencoder,变分自编码器)用于把图片等复杂数据压缩到潜在空间(latent space)中。与传统自编码器(Autoencoder)把图片映射成一个确定的向量不同,VAE 把图片映射成一个概率分布,从而可以随机采样。
公式表示
回顾传统自编码器:假设输入图片 ,潜在向量维度 ,经过 Encoder 得到潜在向量 ,再经过 Decoder 得到重建图片 。训练目标为
但这样得到的潜在空间是离散、杂乱无章的:对于随机生成的向量,Decoder 往往无法解码出有意义的结果,因此不适合生成(generation)任务。所以 VAE 既要把数据编码到潜在空间,又要让潜在空间服从一个性质良好的概率分布,最常见的就是标准正态分布。
VAE 假设真实数据 由潜在空间中的向量 生成,即 ,。其中, 是潜在空间的先验分布, 是给定 时 Decoder 生成 的条件分布, 是 Decoder 的参数。
真实的后验分布 需要计算 ,这个积分难以求解。所以 VAE 训练一个神经网络(Encoder)来近似后验分布:
以 batch size 为 1 为例, 表示单张图片。若 ,潜在维度 ,则 。
为了解决从 采样无法反向传播的问题,VAE 使用重参数化技巧(reparameterization trick):令 ,其中 ,, 表示逐元素乘法。这样 关于 和 可微,随机性被转移到了与参数无关的 上。
VAE 的损失函数由两部分组成:重建损失和正则化损失(KL 散度),分别对应重建的准确性和潜在空间的平整性:
第一项希望 Decoder 从 重建出的结果接近 ,所以
第二项代入正态分布的表达式,可以得到
这一项希望 接近 , 接近 。
ELBO
实际计算时,通常通过最大化 ELBO(Evidence Lower Bound,证据下界)来近似最大化对数似然:
不等号右侧即为 ELBO。实践中通常最小化 ,这正是上面“重建损失 + KL 散度”形式的损失函数。
扩散模型
扩散模型(Diffusion Model)是一类生成式模型:先向数据中逐步添加噪声,再学习逐步去噪、还原数据的过程。其整体发展路线如下:2020 年 UC Berkeley 提出的 DDPM 奠定了扩散模型的理论基础;2021 年,研究者在 DDPM 的基础上进行了大量改进;2022 年,以 Stable Diffusion 为代表的 LDM 在实用性和工程落地方面取得了很大突破;2023 年,DiT 引入 Transformer 结构,大大提升了可扩展性;此后,各种变体和改进不断涌现。
公式表示

前向过程在真实数据 上逐步加入噪声:
其中, 是第 步加噪后的数据, 是高斯噪声。递推可得闭式表达:
其中,, 仍是高斯噪声(独立高斯变量的线性组合仍服从高斯分布)。
训练时,让模型 在给定 和条件 (例如文本 prompt)的情况下,预测第 步加入的噪声(由上式可知,预测噪声与预测原始数据 在数学上等价)。损失函数为
其中, 是真实加入的噪声,即上式中的 。
推理时逐步反向去噪:
其中,, 是第 步的噪声标准差(最后一步取 )。从纯噪声 出发反复迭代,最终得到 的估计。
DDPM
DDPM(Denoising Diffusion Probabilistic Model,去噪扩散概率模型)是 UC Berkeley 的研究者在 2020 年提出的扩散模型,其中噪声预测网络 采用 U-Net 结构。
U-Net 整体是 CNN 结构,分为两个阶段:编码端的下采样阶段负责从输入图像中提取特征,解码端的上采样阶段负责把特征还原为图像。
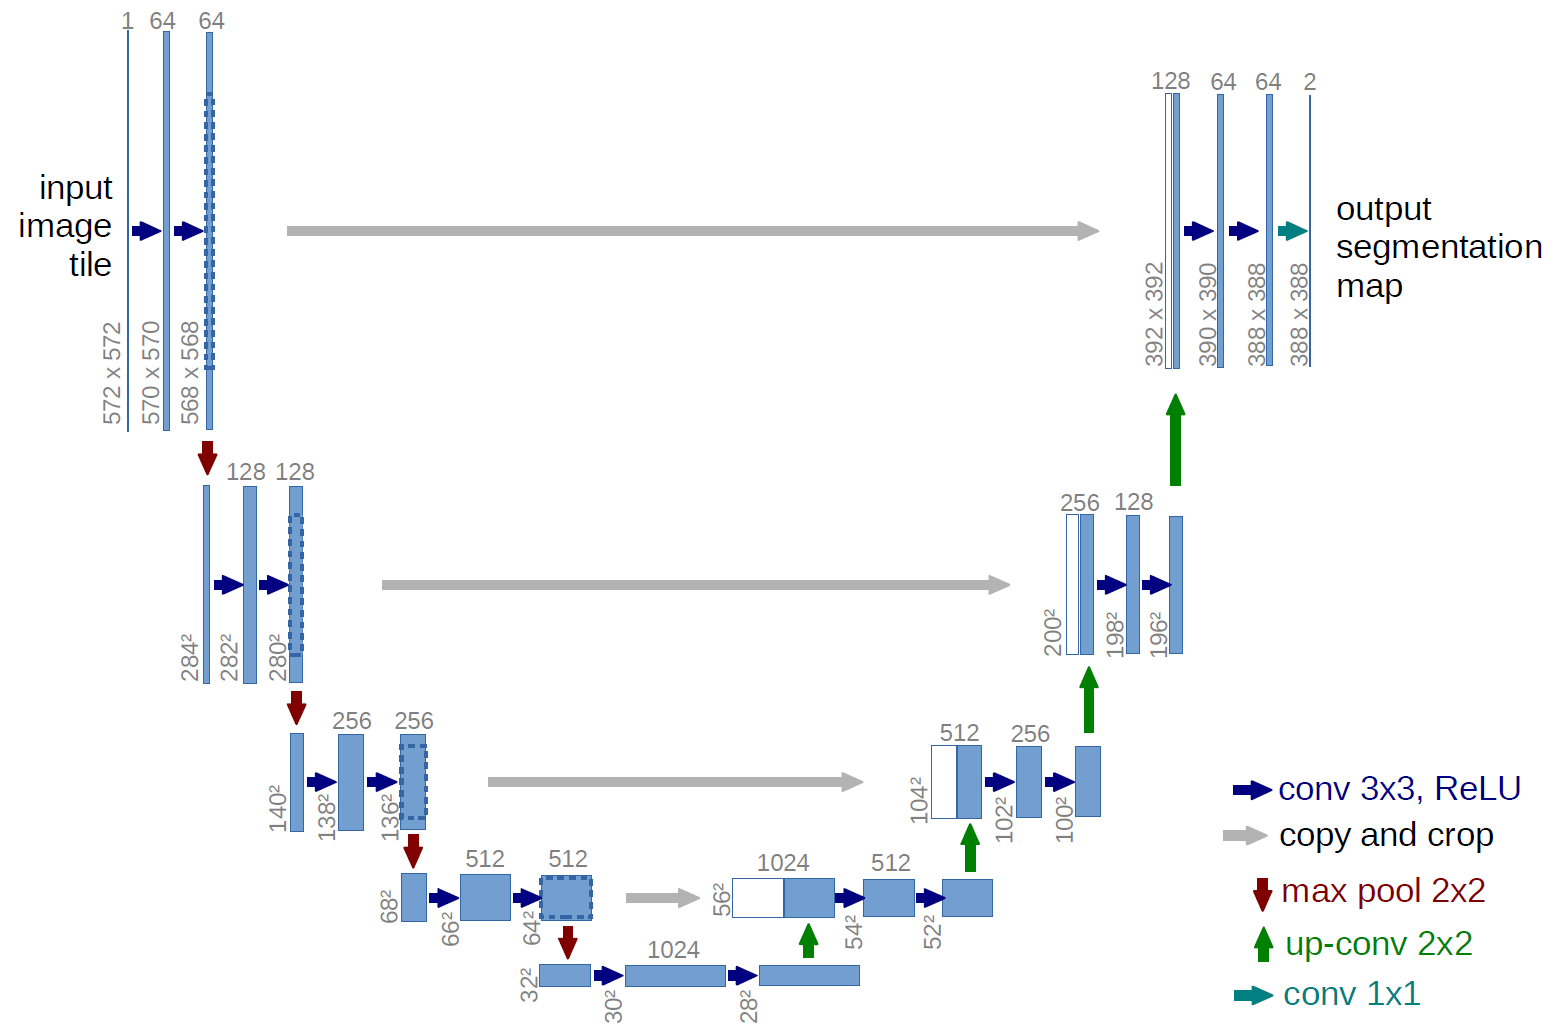
在编码端,每一轮包括卷积层和下采样池化层。卷积层通过若干卷积核提取特征(增加通道数),池化层压缩特征图的空间尺寸(降低分辨率)。以原始 U-Net 为例,一张 的图像经过 2 次 64 通道的 卷积后,特征图尺寸变为 ;再经过 的池化层,特征图尺寸变为 ,然后重复这个过程。经过 4 轮后,特征图尺寸变为 ,再经过 2 次卷积变为 。
在解码端,每一轮包括上采样(可通过反卷积,也叫转置卷积实现)、特征融合(copy and crop)和卷积层。上采样将尺寸扩大一倍,同时将通道数减半;然后把编码端对应层的特征图裁剪后复制过来,与上采样结果在通道维拼接,实现特征融合。这一步使模型能够兼顾压缩后的抽象特征和压缩前的细节特征,最后再通过卷积整合信息。例如,下采样最终得到 的特征图,第一次上采样后变为 ,裁剪、拼接后变为 ;随后经过两次卷积,第一次将通道数减半,尺寸变为 ,第二次保持通道数不变,得到 的特征图。经过 4 轮后得到 的特征图,再经过一个 卷积,得到 的输出。
以上尺寸取自原始 U-Net 论文,该网络用于图像分割,输出的 2 个通道对应 2 个类别。DDPM 使用的 U-Net 在卷积时会补零(padding)以保持尺寸,并加入时间步嵌入,最终输出与输入同尺寸的噪声预测。
LDM
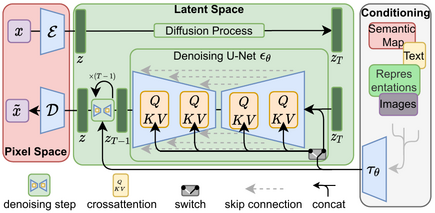
LDM(Latent Diffusion Model,潜在扩散模型)不像 DDPM 那样直接在像素空间上操作,而是先通过 VAE 等自编码器把图像压缩到潜在空间,再在潜在空间中加噪和去噪,从而降低显存和计算需求。Stable Diffusion 是 LDM 最知名、最成功的开源实现。
DiT
DiT(Diffusion Transformer)把传统扩散模型中的 U-Net(CNN 结构)换成 Transformer,用于预测潜在空间中的噪声 。目前一条主流路线是:像 ViT 一样把图像切成 patch 并转换为 token,再用 DiT 完成图像生成。例如,Stable Diffusion 3 使用了进一步发展的 MMDiT(Multimodal Diffusion Transformer),该架构分别处理图像 token 和文本 token,提升了基于语言理解的图像生成能力。
四、具身智能
VLA
VLA(Vision-Language-Action Model,视觉-语言-动作模型)在 VLM 的基础上加入了机器人动作模块,让模型根据当前视觉信息和语言指令控制机器人完成指定任务。与传统的“感知—规划—运动控制”分层模式相比,VLA 把更多模态的信息纳入同一个模型内部,从而实现端到端(end-to-end)控制。

公式表示
核心公式可以表示为机器人的策略
其中, 表示截至时刻 的视觉观测, 表示截至时刻 的机器人状态(关节角度、末端 6D 位姿、末端执行器状态等), 表示语言指令, 表示从时刻 到 的机器人动作序列。 是一次预测的未来动作数量,即动作块(action chunk)的长度,也称 horizon。
每个动作 ,例如
其中, 表示末端在 3 个方向上的位置变化量, 表示末端绕 3 个轴的旋转角度变化量, 表示夹爪开合程度的变化量,此时 。模型既可以先输出动作 token 再解码为 ,也可以直接输出连续的 。
WAM
WAM(World Action Model)在 VLA 根据视觉和语言信息输出动作的基础上,进一步让模型理解世界如何变化、动作会带来什么影响。具体来说,模型不仅要预测未来的动作,还要同时预测未来的世界状态(例如生成未来的视频画面)。
公式表示
核心公式可以表示为模型对未来世界状态和动作的联合预测分布:
其中, 表示从时刻 到 的视觉观测(即未来的世界状态),其余符号的含义与 VLA 相同。